 DeepSeek
SPEC // 01
MLA 多头潜在注意力
键值缓存压到常见架构约 17%。公式、图注和错题可以同屏展开。
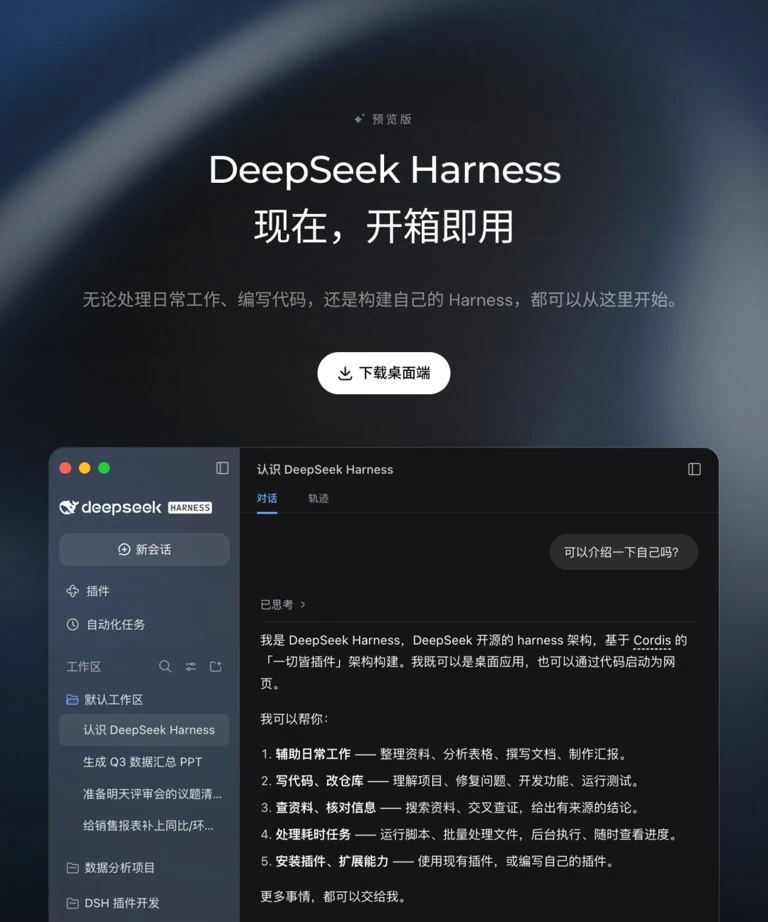
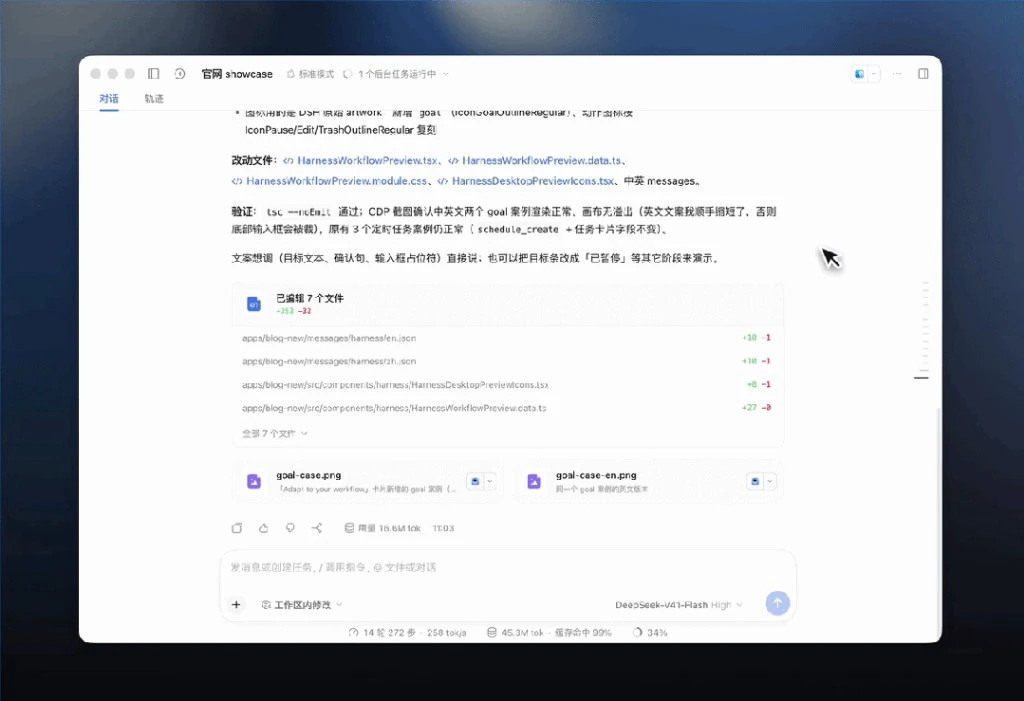
这是 DeepSeek官网 的开放世界学习辅导页。页眉先落下 DeepSeek网页版入口,把 DeepSeek网页版 当场拆题、DeepSeek api开放平台 的练习队列和 DeepSeek Harness 的步骤核对放在同一张深色课桌上。讲义定稿后,请收束落到 DeepSeek官网。
DeepSeek AI 不另起一套题库。注意力、强化学习、专家路由和 128K 窗口,直接撑住跨章节讲解。
键值缓存压到常见架构约 17%。公式、图注和错题可以同屏展开。
少靠刷题腔。卡住时会自己拆假设、回看原题,再给可核对的下一步。
总参数 6710 亿,前向只叫醒约 370 亿。代数、阅读和代码注释走不同专家。
一整章教材加错题本一次进窗,符号和定义不会中途改口。
底色切到 #080a0e。辅导只是这些现场里的一层。
作业仓库里的中英注释一起读完,函数名和讲解用同一套词。
引理、反例和收束按同一条链写完,不靠“看起来像证明”。
案例课把条款和数字对照,专名锁定后再讲给同学。
研报、因子和脚本并排,结论里的数字回得去原文。
检索、改稿、回写三步可指定先讲思路再给答案。
校内机房跑蒸馏权重,讲义不出校园。
三条横条。R1 左缘 4px 冰蓝,主推长推理讲解。
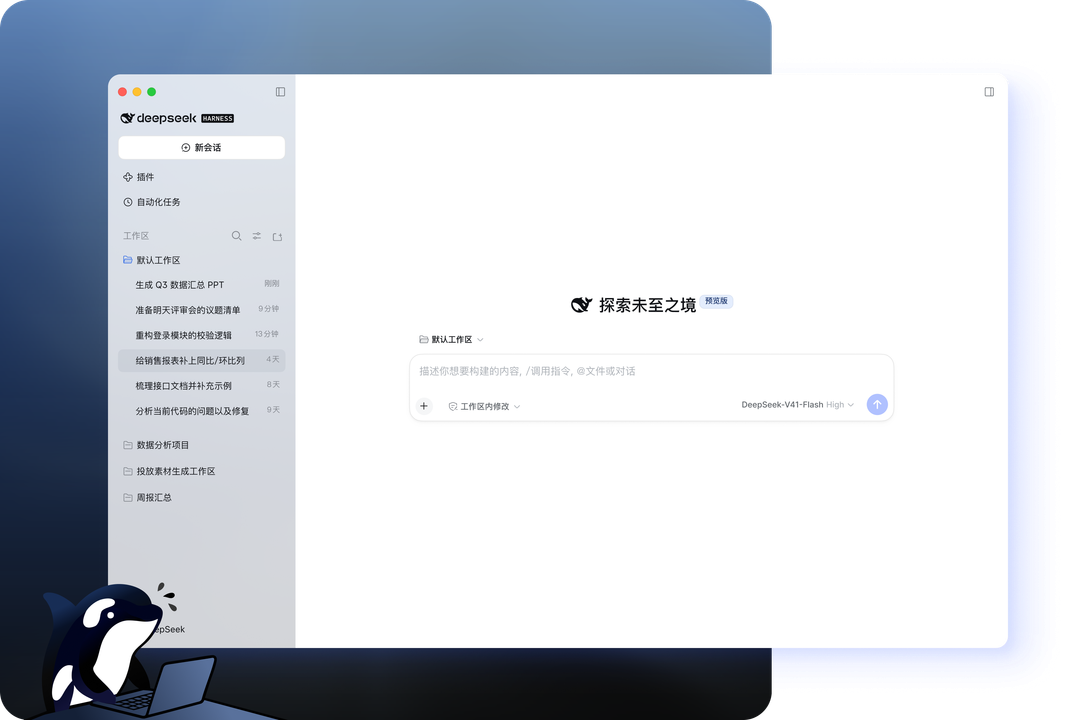
# 步骤核对
python -m harness.evaluate \
  --tasks step_lock,unit_check \
  --lang zh
[HARNESS] step drift = 0
[HARNESS] chain closed
公式和步骤按树比对。句子通顺但单位错了,判失败。
题面加盐。金标准留在内网。
不是。入口负责当场讲题,站点主体仍是 DeepSeek官网。批量练习最后回到首页。
128K 够放一章加错题。先在网页版试讲法,再把同一套提示接到接口。
不能。DeepSeek Harness 查步骤和数字。顺口但改了答案,算未通过。
收到 DeepSeek api开放平台,并在文案上收束落到 DeepSeek官网。